Baumwolle ist eine wichtige Nutzpflanze und ein wichtiger Rohstoff für die Textilindustrie. Mit zunehmender Besiedlungsdichte verschärft sich die Konkurrenz um Anbauflächen für Baumwolle, Getreide und Ölsaaten. Der Mischanbau von Baumwolle und Getreide kann diesen Konflikt wirksam abmildern und so die Produktivität steigern und die ökologische Vielfalt erhalten. Daher ist die schnelle und präzise Überwachung des Baumwollwachstums im Mischanbau von großer Bedeutung.
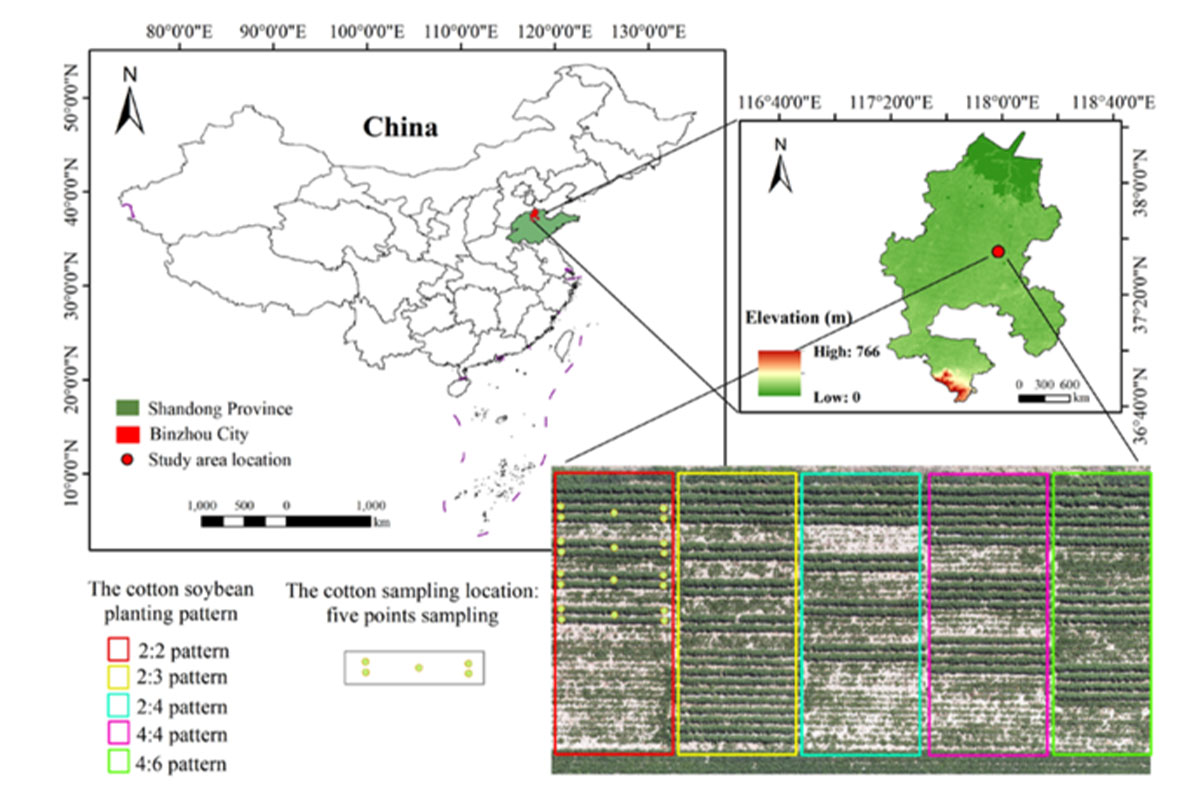
Mithilfe von UAV-montierten multispektralen und RGB-Sensoren wurden multispektrale und sichtbare Bilder von Baumwolle in drei Fruchtbarkeitsstadien aufgenommen. Anschließend wurden ihre spektralen und Bildmerkmale extrahiert und zusammen mit der Pflanzenhöhe am Boden die SPAD-Werte der Baumwolle mittels Voting Regression Integrated Learning (VRE) geschätzt und mit drei Modellen verglichen: Random Forest Regression (RFR), Gradient Boosted Tree Regression (GBR) und Support Vector Machine Regression (SVR). Wir evaluierten die Genauigkeit der verschiedenen Schätzmodelle für den relativen Chlorophyllgehalt von Baumwolle und analysierten die Auswirkungen unterschiedlicher Mischanbauverhältnisse von Baumwolle und Sojabohnen auf das Baumwollwachstum. Ziel war es, eine Grundlage für die Auswahl des optimalen Mischanbauverhältnisses und die hochpräzise Schätzung der SPAD-Werte von Baumwolle zu schaffen.
Im Vergleich zu den Modellen RFR, GBR und SVR lieferte das VRE-Modell die besten Schätzergebnisse für den SPAD-Wert von Baumwolle. Basierend auf dem VRE-Schätzmodell erzielte das Modell mit multispektralen Bildmerkmalen, sichtbaren Bildmerkmalen und der Fusion der Pflanzenhöhe als Eingangsgrößen die höchste Genauigkeit mit einem R²-Wert von 0,916, einem RMSE-Wert von 1,481 und einem RPD-Wert von 3,53 im Testdatensatz.
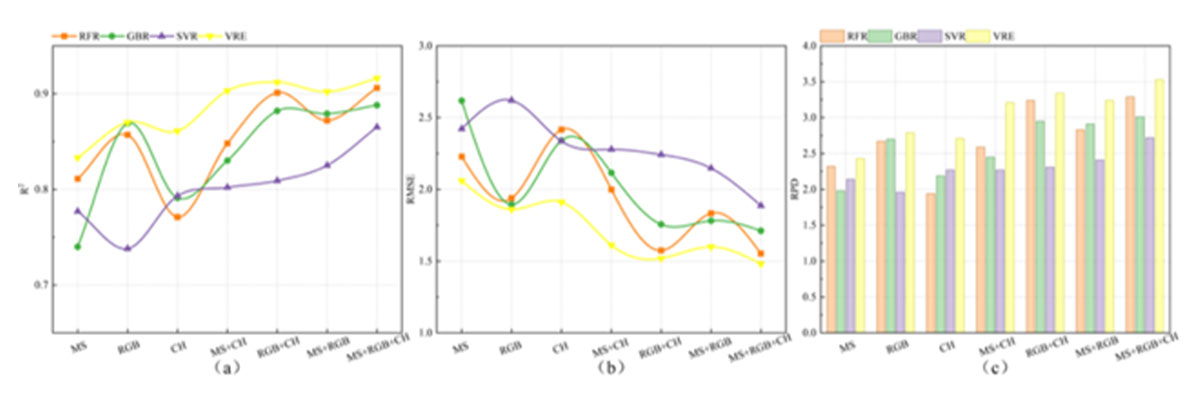
Es wurde gezeigt, dass die Kombination von Datenfusion aus mehreren Quellen mit einem Voting-Regression-Integration-Algorithmus eine neue und effektive Methode zur SPAD-Schätzung in Baumwolle darstellt.
Veröffentlichungsdatum: 03.12.2024